CMR data-extractie: van vrachtbrief naar TMS in seconden
CMR vrachtbrieven automatisch uitlezen met OCR en AI levert gestructureerde data in uw TMS, bespaart tijd en voorkomt fouten.
CMR data-extractie is het automatisch uitlezen van vrachtvliegvelden, van afzender en ontvanger tot colli, gewicht en handtekening, met OCR en AI-documentbegrip. Het resultaat: gestructureerde data die direct in uw TMS klaarstaat, zonder handmatige invoer. Dat scheelt tijd, drukt foutmarges en versnelt facturatie.
Kort samengevat:
- Bij slechte scans en handgeschreven aanvullingen neemt de betrouwbaarheid af, waardoor meer documenten handmatig gecontroleerd moeten worden.
- Het extraheren van identificatie- en partijvelden is cruciaal voor planning en facturatie, terwijl handtekeningen vooral voor geschillen dienen.
- Een succesvolle implementatie begint met het inrichten van ontvangstkanalen, een kleine testset en het afstemmen van nauwkeurigheid en exceptions.
- Relevante datavelden moeten gestandaardiseerd en correct gekoppeld worden, bijvoorbeeld via fuzzy matching when essentiële velden ontbreken of onleesbaar zijn.
- De kosten hangen af van documentvolume en integratiebehoeften, en een proefperiode met eigen documenten helpt de haalbaarheid en nauwkeurigheid te beoordelen.
Inhoudsopgave
- Hoe werkt cmr data-extractie technisch: OCR, AI en modelherkenning
- Welke CMR-velden moet u extraheren en hoe mapt u die naar uw TMS?
- Hoe integreert u cmr data-extractie stap voor stap in uw TMS?
- Wanneer is menselijke controle nodig bij CMR-extractie?
- Wat kost een implementatie en wat levert het op?
- Logentic in de praktijk: wat doet de AI-agent Alex?
- Klaar om cmr data-extractie zelf te testen?
- Bronnen
- Veelgestelde vragen
Hoe werkt cmr data-extractie technisch: OCR, AI en modelherkenning
Elke verwerking begint met optische tekstherkenning. OCR zet de pixels van een scan, foto of pdf om in leesbare tekens, maar herkent geen betekenis. Een OCR-engine ziet “Rotterdam” als tekst, niet als afleveradres. Daarvoor is een tweede laag nodig: AI-documentbegrip, ook wel natural language processing, die begrijpt in welk veld een tekstblok hoort en welke relatie het heeft met andere velden op het document.
Systemen combineren dit vaak met templateherkenning die wordt aangevuld met AI-optimalisatie. Een vast sjabloon herkent snel de standaardlayout van een vervoerder, terwijl een generalistisch machine learning model overweg kan met afwijkende lay-outs, handgeschreven aanvullingen of slecht gescande documenten. De combinatie is bewust: pure templates breken bij elke lay-outwijziging, een puur ML-model is trager en minder voorspelbaar bij bekende documenten.
Cruciaal voor operationele betrouwbaarheid is de validatiescore per document. Elk geëxtraheerd veld krijgt een betrouwbaarheidswaarde. Systemen die edge-detectie, OCR en machine learning combineren leveren die data doorgaans meteen in JSON, XML of CSV aan, klaar voor koppeling.
Wat dit oplevert in de praktijk:
- Snelle herkenning van vaste velden zoals CMR-nummer en datum, zelfs bij matige scankwaliteit.
- Automatische ligging van velden onder een ingestelde betrouwbaarheidsdrempel.
- Directe output in een formaat dat uw TMS zonder tussenstap kan verwerken.
- Geen aparte migratie van bestaande documentopslag nodig.
Welke CMR-velden moet u extraheren en hoe mapt u die naar uw TMS?
Niet elk veld op een CMR-vrachtbrief is even belangrijk voor uw systeem. Voor planning, facturatie en compliance zijn een aantal velden onmisbaar, terwijl andere vooral bewijswaarde hebben.
| Veldcategorie | Voorbeeldvelden | Waarom belangrijk voor TMS |
|---|---|---|
| Identificatie | CMR-nummer, ordernummer, ritnummer | Koppeling aan bestaande zending in TMS |
| Partijen | afzender, ontvanger, vervoerder | Facturatie en klantregistratie |
| Lading | aantal colli, brutogewicht, omschrijving | Capaciteitsplanning en douanewaarde |
| Data | laaddatum, lesdatum, tijdstip aankomst | Planning en Track & Trace |
| Bewijs | handtekening, stempel, opmerkingen | Geschillenafhandeling en compliance |
Normalisatie is minstens zo belangrijk als extractie. Landcodes moeten naar een vaste standaard, gewichten naar één eenheid, adressen naar een consistente structuur en datums naar één formaat, anders loopt de koppeling met uw TMS vast op mismatches. Wanneer een order- of ritnummer ontbreekt of onleesbaar is, is fuzzy matching op basis van combinaties van afzender, datum en gewicht vaak de enige praktische uitweg om toch automatisch te koppelen aan een bestaande zending. Een complete uitleg over CMR-velden laat zien welke gegevens juridisch verplicht zijn en welke vooral operationeel nuttig zijn.
Hoe integreert u cmr data-extractie stap voor stap in uw TMS?
Een werkende integratie bouwt u niet in één stap. De volgorde bepaalt of het systeem op dag één al bruikbare resultaten geeft.
- Richt de ontvangstkanalen in. Configureer een mailbox voor binnenkomende CMR-bijlagen, een uploadmap voor scans en desgewenst mobiele foto-upload voor chauffeurs op locatie.
- Stel de herkenningsflow in. Documenten doorlopen herkenning, extractie, validatie en verdamping voordat ze naar uw TMS gaan.
- Koppel via API of connector. De meeste oplossingen leveren gestructureerde output die rechtstreeks via API of SDK naar uw TMS-database stroomt, zonder tussenliggende Excel-export.
- Draai een proef of concept met een kleine batch. Test met vijftig tot honderd documenten uit uw eigen archief voordat u live gaat.
- Evalueer de foutmarge en schaal op. Pas drempelwaarden aan op basis van de eerste resultaten en breid daarna uit naar het volledige documentvolume.
Pro-tip: Gebruik voor uw POC bewust een mix van scherpe scans en matige mobiele foto’s. Alleen dan zie je hoe het systeem omgaat met scheve of donkere opnames, wat vaak de belangrijkste voorspeller is voor de exception-ratio in productie.
Wie al met Portbase werkt, kan de koppeling met containerevents meteen combineren met de CMR-flow, zodat status en documentatie in één beeld samenkomen.
Wanneer is menselijke controle nodig bij CMR-extractie?
Volledige automatisering zonder controle is geen realistisch doel, en ook niet wenselijk. Onduidelijke handtekeningen worden meestal niet volledig geparsed, maar wel vastgelegd als bewijsstuk voor latere geschillen. Dat is precies waar management by exception zijn waarde toont: de AI verwerkt de routine, mensen behandelen de afwijkingen.
Concrete criteria voor doorschakeling naar handmatige controle:
- Een veld scoort onder de ingestelde betrouwbaarheidsdrempel.
- Een verplicht veld, zoals gewicht of ontvanger, ontbreekt volledig.
- De geëxtraheerde waarde wijkt sterk af van wat er in het TMS al bekend is over die zending.
- Het document bevat een handgeschreven aanvulling die niet met zekerheid te interpreteren is.
Voor governance zijn een audit-trail en vaste bewaartermijnen onmisbaar, zeker bij geschillen over transportschade. Verwerk persoonsgegevens volgens de AVG en regel logging en toegangscontrole goed; data hoeft niet buiten de EU verwerkt te worden om aan die eisen te voldoen. Elke handmatige correctie die een medewerker doorvoert, kan bovendien terugvloeien als trainingssignaal, waardoor het model bij herhaling van vergelijkbare documenten minder vaak dezelfde fout maakt.
Wat kost een implementatie en wat levert het op?
Voordat u een leverancier selecteert, is een korte checklist nuttiger dan een lange demo. Inventariseer eerst welke documenttypes u ontvangt, in welk volume, via welke kanalen, en welke TMS-velden echt gevuld moeten worden. Verzamel een representatieve testset van honderd tot tweehonderd documenten en spreek vooraf af wat een geslaagde POC betekent: welke nauwkeurigheid, welk percentage exceptions, welke verwerkingstijd.
De KPI’s die de businesscase onderbouwen zijn concreet meetbaar:
- Gemiddelde verwerkingstijd per document, van ontvangst tot push naar TMS.
- Extractienauwkeurigheid per veldcategorie.
- Aantal exceptions per duizend documenten.
- Tijd tussen aflevering en factuur, als indicator voor cashflow-impact.
Praktijkimplementaties tonen dat een groot deel van de documenten automatisch doorloopt zonder menselijke tussenkomst, met de resterende documenten in een overzichtelijke exception-wachtrij. Dat vertaalt zich direct in minder handmatige invoeruren, een lagere correctielast door minder typefouten, en facturen die eerder de deur uit kunnen omdat de onderliggende data al gevalideerd is.
Logentic in de praktijk: wat doet de AI-agent Alex?
AI-agents verwerken binnenkomende CMR-documenten door mails, bijlagen en gescande vrachtbrieven te lezen, de relevante velden te extraheren en die rechtstreeks in het bestaande TMS te plaatsen.
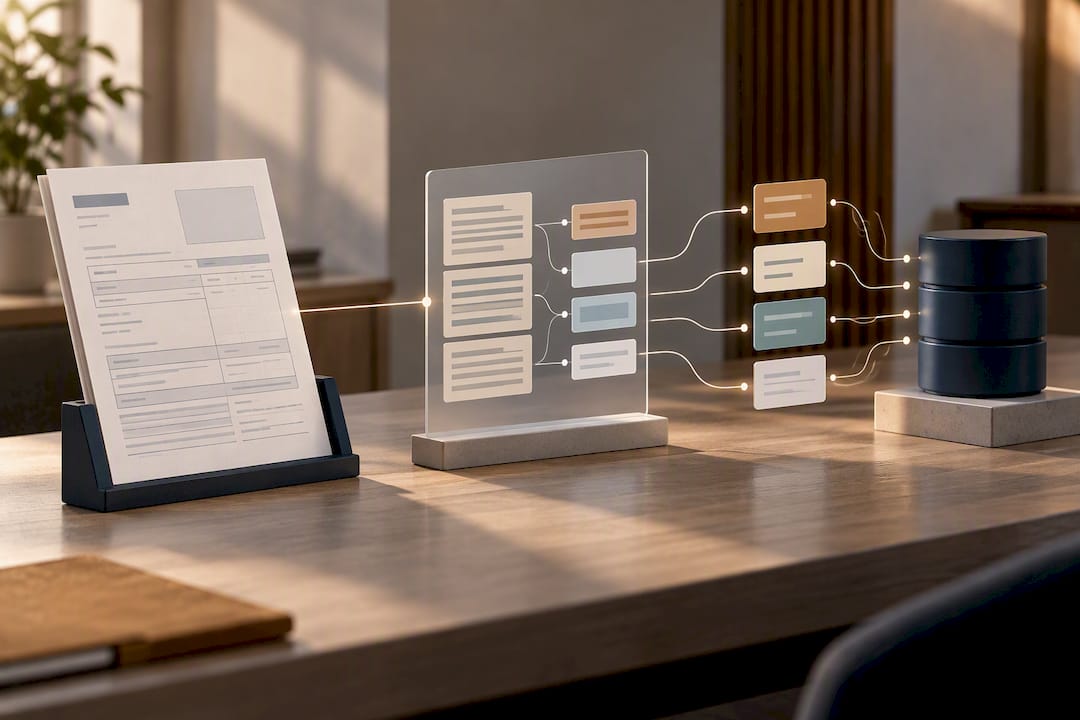
Het verschil zit niet alleen in snelheid. Management by exception betekent dat operators alleen de documenten zien die daadwerkelijk aandacht vragen, terwijl de rest van de stroom ongemerkt doorloopt naar het systeem. Voor teams die dagelijks tientallen tot honderden vrachtbrieven verwerken, verschuift dat de rol van medewerkers van invoerwerk naar controlewerk, wat op de vloer meteen voelbaar is in de werkdruk.
Klaar om cmr data-extractie zelf te testen?
Waar generieke OCR-tools losse documenten verwerken zonder verdere koppeling, richt Logentic zich specifiek op de stap die er echt toe doet: data die zonder omweg in uw bestaande TMS terechtkomt, zonder dat u van systeem moet wisselen.

De B/L & CMR Processing dienst van Logentic is gebouwd rond precies de flow die in dit artikel staat beschreven: herkenning, validatie, mapping en push naar uw TMS, met menselijke controle voor de uitzonderingen. Wie ook worstelt met de instroom van boekingsmails, vindt in Email Automation de logische aanvulling, omdat veel CMR-documenten toch als bijlage binnenkomen. Een proefperiode met eigen documenten laat direct zien welke nauwkeurigheid en verwerkingstijd u mag verwachten, zonder dat huidige systemen worden aangeraakt. Vraag een demo aan via de freight forwarder software pagina en start met een kleine batch van uw eigen vrachtbrieven.
Bronnen
- CMR-vrachtbrieven automatisch verwerken — WerkstroomAI
- Slimme verwerking vrachtbrieven (TMS IoT)
- Vrachtbrieven automatiseren - Qintos
Veelgestelde vragen
Wat is het verschil tussen OCR en volledige CMR data-extractie?
OCR zet alleen tekst op een scan om in leesbare karakters, zonder betekenis toe te kennen. Volledige extractie voegt AI-documentbegrip toe dat herkent welk tekstblok bij welk veld hoort, zoals afzender of gewicht, en levert die data gestructureerd aan uw TMS.
Hoe betrouwbaar is geautomatiseerde herkenning bij slechte scans?
Bij matige scankwaliteit of handgeschreven aanvullingen daalt de betrouwbaarheidsscore van het systeem, waardoor het document automatisch naar een handmatige controle gaat. Onduidelijke handtekeningen worden vaak niet volledig geparsed maar wel vastgelegd als bewijsstuk.
Welke CMR-velden zijn het belangrijkst voor mijn TMS?
Identificatievelden zoals CMR- en ordernummer, partijgegevens, lading en data voor laden en lossen wegen het zwaarst voor planning en facturatie. Handtekeningen en opmerkingen zijn vooral relevant als bewijs bij geschillen.
Wat kost een oplossing zoals Logentic voor CMR-verwerking?
Logentic publiceert geen vaste prijzen voor de B/L & CMR Processing dienst; een offerte volgt na een intake op basis van documentvolume en gewenste integraties. Actuele informatie vraagt u aan via de freight forwarder software pagina.
Hoe lang moeten we CMR-documenten en logbestanden bewaren?
Bewaartermijnen hangen af van uw sector en interne compliance-afspraken, maar een audit-trail met logging is in elk geval nodig voor geschillen over transportschade. Verwerk persoonsgegevens daarbij volgens de AVG, ook wanneer de data binnen de EU blijft.
Aanbevelingen
Wil je zien hoe Logentic dit werk automatiseert?
Plan een gesprek →