Incoterms herkennen in e-mails en documenten: hoe werkt dat?
Ontdek hoe je Incoterms automatisch herkent in mails en documenten, fouten terugdringt, zendingen correct koppelt en een controleerbaar auditspoor bijhoudt.
Ja, Incoterms herkennen in inkomende e-mails en logistieke documenten is technisch haalbaar en al in productie bij expediteurs die hun TMS-invoer automatiseren. Het proces verloopt in vier stappen: detectie van de tekstvariant, normalisatie naar een gecodeerde waarde, koppeling aan de juiste zending en validatie tegen andere documenten. Bij twijfel grijpt een medewerker in, en elke stap laat een spoor achter in een audit trail.
Kort samengevat:
- Automatiseren van Incoterms-herkenning in een TMS is technisch haalbaar en wordt al bij expediteurs toegepast die hun documenten automatisch laten parseren.
- Het herkennen gebeurt via een herkenningspijplijn die tekst lokaliseren, combineren met regex en NER, en scoren op vertrouwen voor betrouwbare validatie.
- Normalisatie naar gestandaardiseerde codes en cross-validatie tussen documenten voorkomt dat onjuiste Incoterms in het systeem belanden.
- Door een auditable workflow met duidelijke statusregelingen blijven menselijke controles essentieel, vooral bij twijfel of conflicterende gegevens.
- Een implementatie start met gerichte datasetverzameling, shadow-testing en vaste SLA’s om fouten door OCR en oude documenten te minimaliseren.
Inhoudsopgave
- Wat betekent incoterms herkennen precies in een TMS-context?
- Technische pijplijn: van e-mail of PDF naar gedetecteerde incoterm
- Normalisatie: van tekstvariant naar canoniek TMS-veld
- Hoe worden conflicten tussen documenten opgelost?
- Hoe implementeer je incoterms-herkenning stap voor stap?
- Praktijkperspectief: waarom menselijk toezicht blijft nodig
- Hoe Logentic incoterms-herkenning naar productie brengt
- Geraadpleegde standaarden voor mapping en compliance
- Bronnen
- Veelgestelde vragen
Wat betekent incoterms herkennen precies in een TMS-context?
Incoterms herkennen gaat hier niet over de elf regels van de Incoterms zelf, maar over de techniek om die afkortingen automatisch te vinden in binnenkomende documenten en ze correct in een systeem te krijgen. Wie op zoek is naar uitleg over wat EXW of DAP betekent, leest Incoterms 2020 uitgelegd. Dit artikel gaat over iets anders: hoe herkent een systeem “FOB Rotterdam” in een boekingsmail, en hoe komt dat automatisch en correct in het juiste zendingsveld van je TMS terecht?
Dat onderscheid is niet triviaal. Een expediteur ontvangt Incoterms in wildgroei aan formats: in de hoofdtekst van een e-mail, in een PDF-bijlage, in een handtekeningblok, of verstopt in een oude offerte die per ongeluk wordt meegestuurd. Herkenning betekent dat een systeem die tekst vindt, de juiste waarde eruit filtert, en die waarde omzet naar een code die je TMS begrijpt. Zonder die stap blijft iemand handmatig e-mails doorscrollen op zoek naar drie letters die het verschil maken tussen wie welke transportkosten draagt.
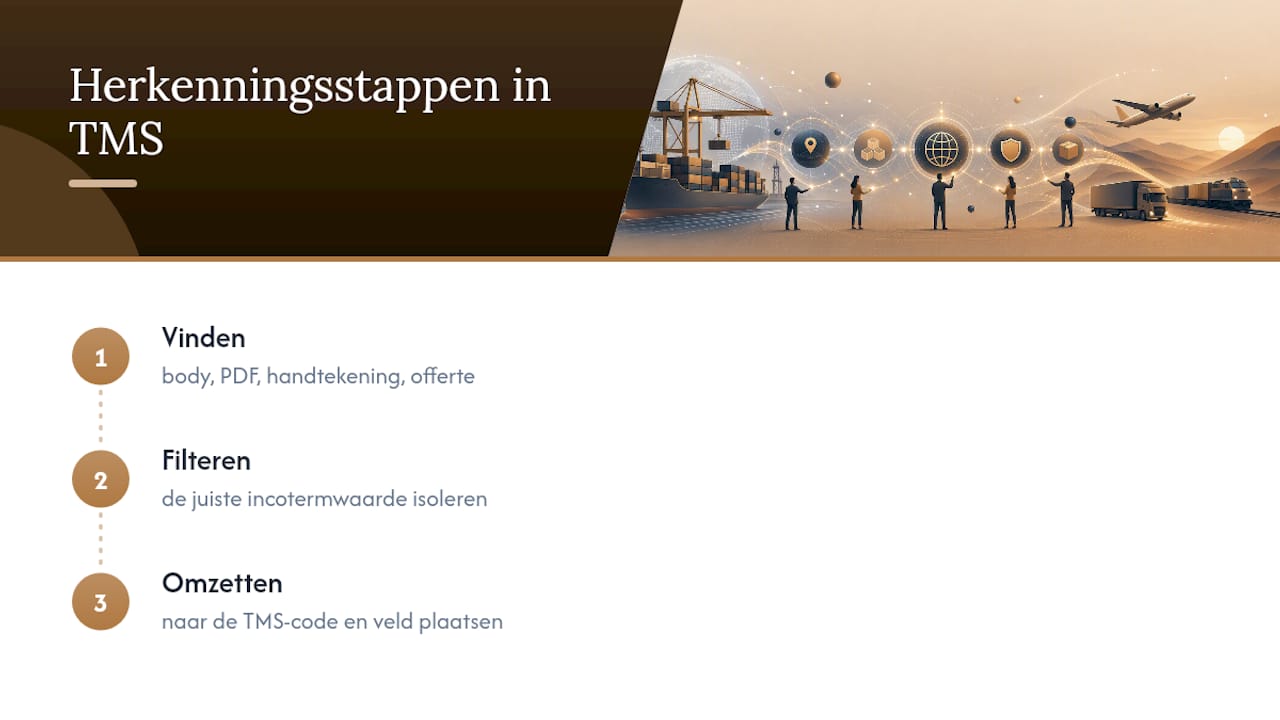
Technische pijplijn: van e-mail of PDF naar gedetecteerde incoterm
Een herkenningspijplijn bestaat uit een vaste volgorde van stappen. Elke stap lost een specifiek probleem op, en het overslaan van een stap is meestal waar fouten ontstaan.
- Preprocessing. PDF’s worden geparsed op tekstlagen, gescande documenten gaan door OCR, en e-mails worden gesplitst in koptekst, body en handtekening.
- Lokalisatie van de bronpassage. Het systeem onthoudt exact waar de term vandaan komt: paginanummer bij een PDF, regelnummer bij een document, of de specifieke e-mailregel bij een bericht.
- Hybride herkenning. Named entity recognition combineert met regex-patronen en fuzzy matching om afwijkende schrijfwijzen op te vangen, zoals “F.O.B.” of “Fob Rotterdam haven”.
- Confidence scoring. Elke gevonden waarde krijgt een score en een voorlopige status: gevonden met hoge zekerheid, gevonden maar twijfelachtig, of niet gevonden.
- Metadata-opslag. De brontekst, het bestand en de exacte locatie worden samen met de score bewaard voor latere controle.
De reden om NER te combineren met regex is simpel: alleen regex mist context, en alleen NER mist de starheid die nodig is om een driecijferige code zoals “FCA” strikt te herkennen. Een goede pijplijn gebruikt beide, met fuzzy matching als vangnet voor tikfouten en scanruis.
Pro-tip: Laat je systeem nooit alleen op hoofdletters zoeken. E-mailhandtekeningen en oude offertes bevatten vaak Incoterms in kleine letters of met spaties ertussen, en die worden anders stelselmatig gemist.
Normalisatie: van tekstvariant naar canoniek TMS-veld
Herkenning zonder normalisatie levert alleen ruwe tekst op, en daar kan een TMS niets mee. De oplossing is twee waarden naast elkaar bewaren: de letterlijke tekst zoals hij in het document stond, en een genormaliseerde code die overal hetzelfde betekent. Dat principe komt direct terug in de manier waarop de Key Trade Documents and Data Elements (KTDDE) tekstvelden en gecodeerde velden strikt gescheiden documenteert.
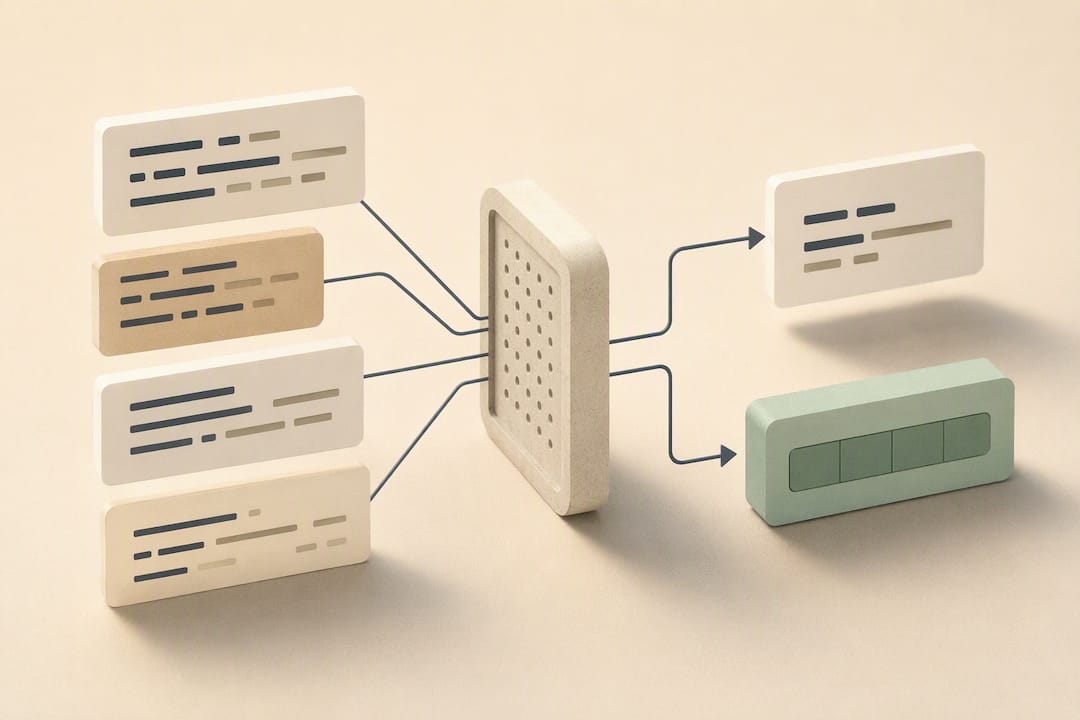
Voor consistente mapping is een canoniek referentiemodel onmisbaar. Het ICC Digital Standards Initiative biedt daarvoor een framework met een gezamenlijke glossary over 36 handelsdocumenten, zodat een term niet per document opnieuw wordt geïnterpreteerd. Voor multimodaal transport vult UN/CEFACT dat aan met de Reference Data Models, die een semantische basis leveren voor het mappen van transportgegevens naar een TMS-schema zonder dat systeem te vervangen.
Een praktische veldset in het TMS ziet er zo uit:
| Veld | Inhoud |
|---|---|
| document_id | Unieke identifier van het bronbestand |
| bookingref | Boekingsreferentie of zendingsnummer |
| incoterms_text | Letterlijke tekst zoals aangetroffen |
| incoterms_code | Genormaliseerde code, bijvoorbeeld FOB of DAP |
| confidence | Score van de herkenning |
| source_span | Pagina, regel of e-mailregel van de bron |
Normalisatielogica moet ook fallbackregels bevatten. Als de eerste match onzeker is, controleert het systeem een tweede bron, bijvoorbeeld de factuur naast de boekingsmail, en kiest bij aanhoudende twijfel voor een fuzzy match boven een gok.
Hoe worden conflicten tussen documenten opgelost?
Eén document is nooit de enige waarheid. Een boekingsmail kan “CIF” vermelden terwijl de bijgevoegde factuur “CFR” toont, en dat verschil moet een systeem opmerken voordat het iets naar het TMS schrijft. Cross-validatie tussen e-mail, factuur, bill of lading, CMR en air waybill is daarom een verplichte stap, niet een extra.
Een werkbaar statusmodel kent vier toestanden:
- Niet gevonden: geen enkele bron bevat een herkenbare Incoterm.
- Ambigu: bronnen spreken elkaar tegen of de score is te laag.
- Gevalideerd: meerdere bronnen bevestigen dezelfde waarde.
- Gecorrigeerd: een medewerker heeft de waarde na review aangepast.
Elke stap wordt gelogd: bronbestand, regelnummer, confidence-score, welke mappingstap is toegepast en of een gebruiker heeft ingegrepen. Die logging is precies waarom het WCO Data Model adviseert om automatisch herkende data eerst te toetsen aan de zendingcontext voordat die doorstroomt naar douanesoftware.
Belangrijke prestatie-indicatoren voor deze aanpak zijn onder andere het aandeel zendingen met brondiscrepanties, het aandeel zendingen dat menselijke review vereist, en de tijd die nodig is voor correcte invoer van gegevens in het TMS. Wie deze factoren goed monitort, krijgt inzicht in welke documenttypes het meeste ambiguïteit veroorzaken.
Hoe implementeer je incoterms-herkenning stap voor stap?
Een pilot slaagt of faalt op de voorbereiding, niet op het model zelf. Onderstaande volgorde voorkomt de meeste valkuilen.
- Scope en succescriteria vastleggen. Bepaal welke documenttypes meedoen (e-mail, B/L, CMR, factuur) en welke TMS-velden gevuld moeten worden.
- Dataset opbouwen en annoteren. Verzamel echte voorbeelden uit je eigen archief, inclusief edge-cases zoals gescande documenten en oude offertesjablonen.
- Shadow-run naast het bestaande proces. Laat het systeem meelopen zonder dat het al zelfstandig in het TMS schrijft, met een duidelijk rollbackscenario als de uitkomsten afwijken.
- Operationaliseren met SLA’s. Stel vast binnen hoeveel tijd een ambigue zaak door een medewerker bekeken moet zijn, en plan een terugkerende update van regels en modellen op basis van nieuwe fouten.
De grootste valkuilen zitten zelden in het model zelf. OCR-fouten op gescande CMR’s, afwijkende schrijfwijzen zoals “Ex Works” in plaats van “EXW”, en oude e-mailhandtekeningen met verlopen leveringsvoorwaarden zorgen voor het merendeel van de misclassificaties. Verkeerde koppeling aan de zending, bijvoorbeeld via een verouderd boekingsnummer, is een net zo grote bron van fouten als een fout in de herkenning zelf.
Pro-tip: Begin een pilot met je meest gestandaardiseerde documentstroom, zoals digitale boekingsmails van een vaste klant. Pas als die stabiel draait, voeg je de rommelige categorie toe: gescande CMR’s en oude offertesjablonen.
Praktijkperspectief: waarom menselijk toezicht blijft nodig
De meeste misclassificaties ontstaan niet doordat een model de Incoterm niet kent, maar doordat een document verkeerd is gekoppeld of een OCR-artefact een letter verandert. Automatisering die dat soort fouten stilzwijgend doorlaat naar het TMS is gevaarlijker dan geen automatisering. Een auditable workflow met expliciete statussen dwingt precies daar een controlemoment af waar het risico zit: bij ambiguïteit, niet bij elke zending.
— Bogdan
Hoe Logentic incoterms-herkenning naar productie brengt
Een AI-agent kan binnenkomende boekingsmails en documenten lezen, Incoterms en andere zendingsgegevens herkennen, en die automatisch en gevalideerd in een bestaand TMS zetten. Handmatige verwerking van zulke e-mails kost vaak enkele minuten, maar met automatisering kan die taak in seconden worden gedaan, zonder dat het bestaande systeem vervangen of gemigreerd hoeft te worden.

Dat werkt over de volle breedte van je documentstroom. De module voor e-mailautomatisering vangt boekingsmails en offerteaanvragen op, terwijl B/L- en CMR-verwerking dezelfde herkenning toepast op transportdocumenten. Elke stap houdt een audit trail bij, inclusief bronspan en confidence-score, zodat een medewerker bij twijfel precies ziet waar een waarde vandaan komt en waarom.
Wil je zien hoe dat voor jouw documentstroom werkt? Vraag een demo aan via de pagina over e-mailautomatisering en ontdek binnen een pilot of Incoterms-herkenning voor jouw TMS haalbaar is.
Geraadpleegde standaarden voor mapping en compliance
Deze bronnen zijn nuttig tijdens implementatie omdat ze het canonieke datamodel leveren waarop normalisatie steunt:
- ICC Digital Standards Initiative voor het glossaryframework over handelsdocumenten.
- KTDDE voor de scheiding tussen tekst- en codevelden.
- UN/CEFACT Reference Data Models voor multimodale mapping.
- WCO Data Model voor validatie tegen zendingcontext.
Bronnen
- ICC Digital Standards Initiative launches complete framework for supply chain digitalisation
- Reference Data Models (RDM)
- WCO Data Model
Veelgestelde vragen
Kan een systeem Incoterms herkennen uit een gescande PDF?
Ja, via OCR gevolgd door dezelfde hybride herkenning die op platte tekst wordt toegepast. Scankwaliteit blijft de grootste risicofactor, dus een systeem moet een lage confidence-score toekennen zodra het OCR-resultaat onzeker is.
Wat is het verschil tussen incoterms_text en incoterms_code?
incoterms_text is de letterlijke tekst zoals in het document, incoterms_code is de genormaliseerde waarde die je TMS gebruikt. Beide waarden bewaren is nodig voor audit doeleinden, zoals ook de KTDDE documenteert.
Hoe voorkom je dat een verkeerde Incoterm in het TMS terechtkomt?
Door cross-validatie tussen minstens twee documenten, zoals de boekingsmail en de factuur, voordat een waarde als gevalideerd wordt gemarkeerd. Bij tegenspraak tussen bronnen krijgt de zaak de status ambigu en gaat die naar een medewerker.
Vervangt automatische herkenning mijn bestaande TMS?
Nee. Logentic’s aanpak koppelt aan bestaande systemen zoals CargoWise, Softpak, Descartes en Boltrics zonder migratie, en schrijft herkende waarden rechtstreeks in de velden die je TMS al gebruikt.
Wat kost een oplossing zoals Logentic?
Actuele prijzen staan niet openbaar vermeld en worden na een intake op maat opgesteld, afhankelijk van documentvolume en workflows. Een gratis proefperiode is mogelijk om eerst te testen of de herkenning voor jouw documentstroom volstaat.
Aanbevelingen
Wil je zien hoe Logentic dit werk automatiseert?
Plan een gesprek →